音频人声分离工具
音频人声分离工具是一款把一首歌拆成「人声」和「伴奏」两条音轨的桌面软件,基于 Meta 开源的 Demucs 混合Transformer 模型(人工智能音乐源分

产品介绍
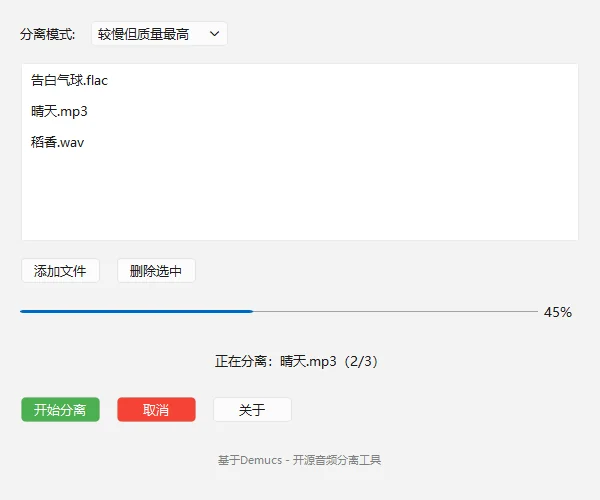
音频人声分离工具是一款把一首歌拆成「人声」和「伴奏」两条音轨的桌面软件,基于 Meta 开源的 Demucs 混合Transformer 模型(人工智能音乐源分离领域公认的高质量方案)。内置两档分离模式:标准模式速度快、效果出色;高精度模式启用微调版模型 htdemucs_ft,分离更干净、串音更少,适合对质量要求高的场景。AI 分离模型全部内置在软件里,约 400MB 权重随安装包一起装到电脑,安装完成即可离线使用,永不联网下载。软件会自动检测你的显卡:有 NVIDIA 显卡时启用 GPU 加速,分离速度快几倍;没有显卡也能用,CPU 模式自动开启多线程优化。支持批量添加多个音频文件排队处理,实时进度条随时可取消,输出文件自动以「原文件名_人声」「原文件名_背景声」命名,互不覆盖。K歌伴奏提取、视频配音消音、翻唱素材制作,一首歌几十秒搞定。纯本地处理,音频不上传任何服务器,免管理员权限安装,无广告,永久免费。
功能特点
- 基于 Meta 开源 Demucs 混合Transformer 模型,分离质量业界领先
- 两档分离模式:htdemucs 标准模式快速出片,htdemucs_ft 高精度模式效果最佳
- 输出两条独立音轨:人声与背景声(伴奏/环境声)自动分轨命名
- AI 模型约 400MB 权重全部内置,安装后完全离线可用
- 自动检测 NVIDIA 显卡并启用 CUDA 加速,分离速度成倍提升
- 无显卡电脑可用,CPU 模式自动多线程优化并调优重叠参数
- 支持批量添加音频文件排队分离,一次处理整个列表
- 实时进度条显示整体进度,随时取消剩余任务
- 模型只加载一次,批量处理不重复初始化,速度快
- 输出目录自动创建、文件自动命名(_人声 / _背景声),互不覆盖
- 界面显示显卡显存信息,硬件状态一目了然
- 含「关于」信息与基于 Demucs 的开源声明,合规透明
- 纯本地处理,音频数据不上传任何服务器
- 免管理员权限安装,无广告无捆绑
使用教程
人声分离怎么用?标准与高精度两档 展开 / 收起
想拿伴奏练歌、想单独听人声,都需要先分轨。这里用本地模型,音频不用上传。
开始之前
- Windows 电脑,装好「音频人声分离」
- 一段音乐或音频文件
操作步骤
-
1
先选标准模式试一首
htdemucs 标准模式速度快,先确认效果可接受;满意后再用 htdemucs_ft 高精度重跑。
-
2
批量添加可排队处理
支持一次添加多个音频排队分离,模型只加载一次,批量处理不重复初始化。
-
3
有 N 卡会自动启用 CUDA 加速
自动检测 NVIDIA 显卡;无显卡时 CPU 模式会多线程优化,速度慢一些但可用。
-
4
在输出目录找到 _人声 与 _背景声
文件自动命名,互不覆盖。进度条显示整体进度,可随时取消剩余任务。
常见问题
需要联网下载模型吗
分离后还有残留怎么办
进阶技巧
- 先用标准档跑一遍确认可用,再对满意的曲目用高精度重跑。
- 分离后的伴奏适合练歌,不建议直接用于商业发布。
版本历史
-
v1.0.0 最新版 2026-10-261.0 正式版本首次发布
问题与建议
还没有已展示的建议,来做第一个反馈的人吧。
提交建议或问题
提交后经人工审核才会展示在本页面。如需回访可留下联系方式(仅官方可见,不会对外展示)。
更多音频与语音应用
同分类下的其他产品,同样免费好用。
电脑音频内录器
AI智能配音
音视频字幕生成器
歇会儿 · 解压轻音乐
这款软件支持自动更新
装好官方「免费软件中心」,全部 43 款软件一键装好——新品上架、版本更新自动出现,不用再回网站挨个下载。